

随着人工智能的不断进步,文本转语音(TTS)技术已经成为我们日常生活中不可或缺的一部分。
从语音助手到有声读物,再到角色配音,TTS 的应用场景日益广泛。
然而,尽管市面上已有众多 TTS 模型,但它们往往需要庞大的计算资源,这对许多开发者和中小型企业来说是一个不小的挑战。
这个仅拥有 82M 参数的高效 TTS 模型,只需轻轻一点,就能在几秒钟内生成几分钟的高质量语音。不需要昂贵的设备,也不需要复杂的配置。
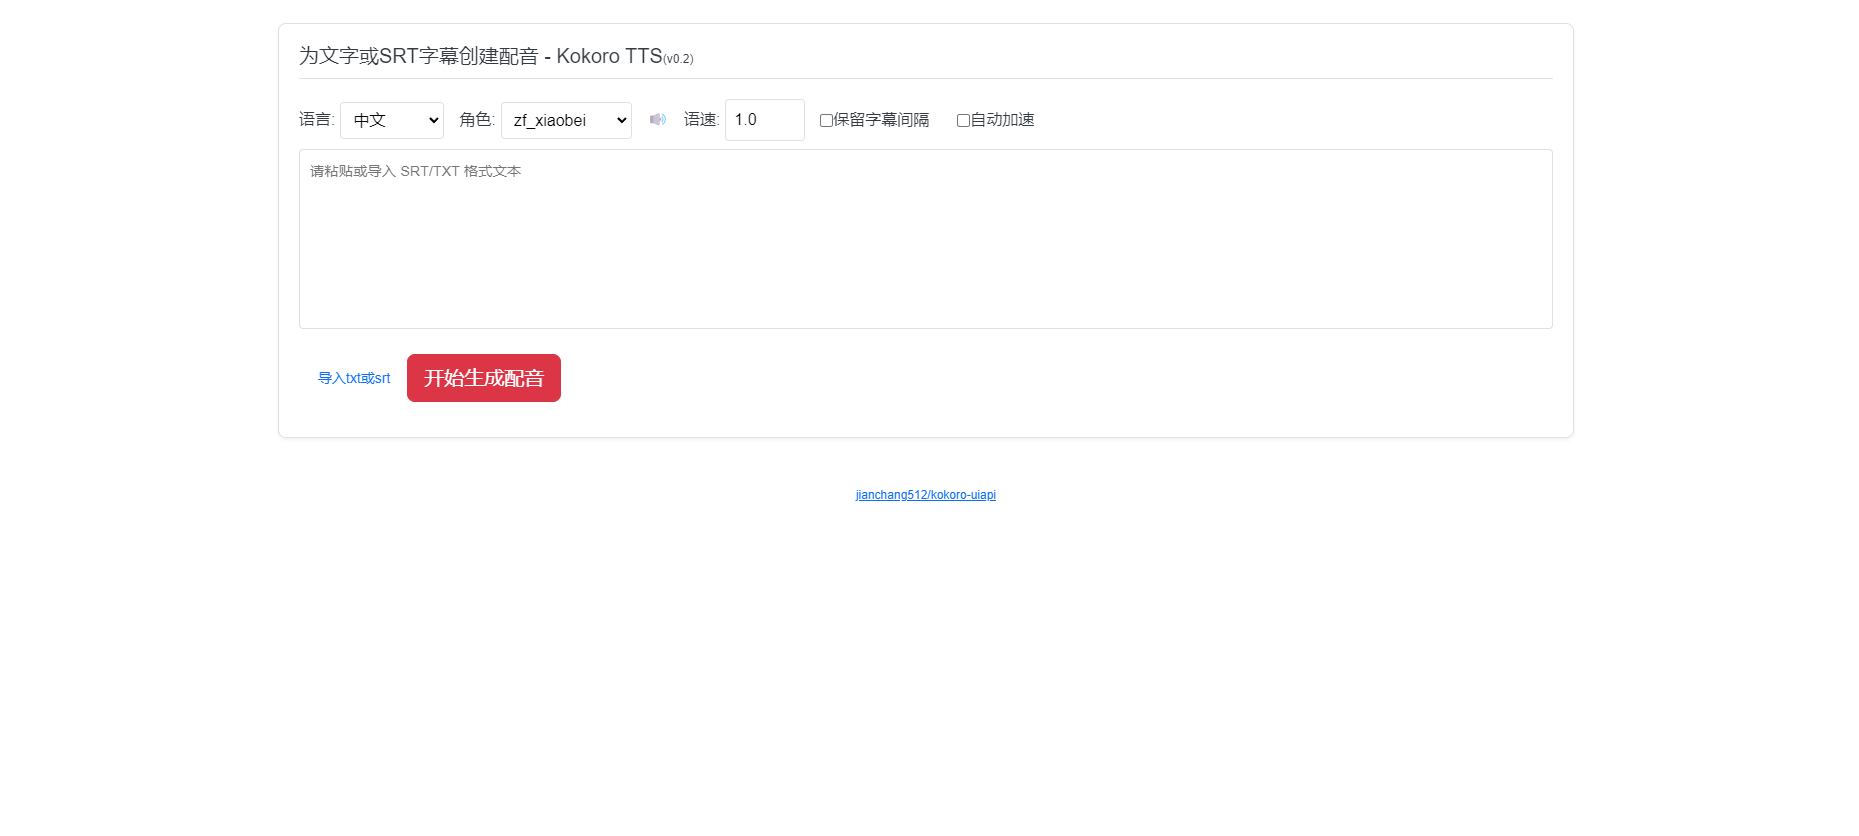
核心亮点
参数小,性能强: 拥有仅 82M 参数,与其他需要庞大资源的模型相比,它显得格外高效。
多语言支持:支持中文、韩语、日语、法语、英语等五种语言。
多人物音色支持:提供了多达18种男女人物音色。
实时语音生成:在普通CPU上,可以近乎实时生成语音,而在GPU上,生成速度更是快到了令人难以置信的50倍实时速度。
自然的语音合成:生成的语音自然流畅,接近人类语音。无论是用于语音助手、有声读物,还是角色配音,均能提供高质量的语音体验。
支持导入SRT字幕文件生成配音。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END